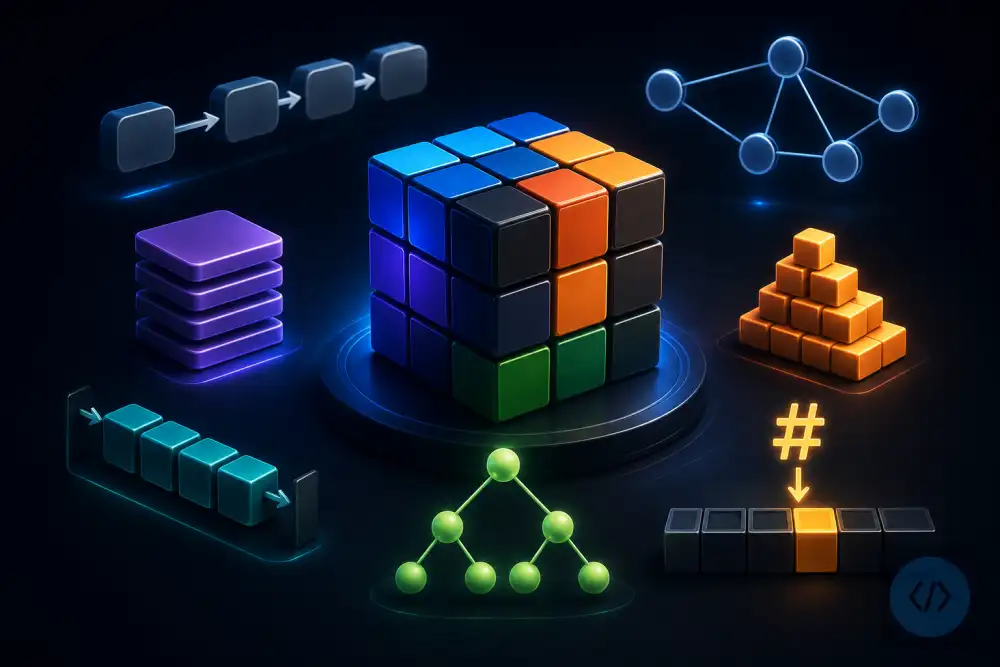
Las estructuras de datos son formas organizadas de almacenar y gestionar información en un programa. Elegir la estructura correcta para cada problema puede ser la diferencia entre un código que funciona en milisegundos y uno que tarda minutos. No es exagerado decir que entender bien las estructuras de datos es una de las habilidades más importantes que puedes desarrollar como programador.
En esta guía vas a ver las estructuras de datos más fundamentales, cómo funcionan por dentro, cuándo usar cada una y cómo implementarlas en Python y JavaScript.
Por qué importa elegir la estructura correcta
Imagina que tienes una lista de un millón de usuarios y necesitas comprobar si un email concreto ya está registrado. Podrías recorrer la lista de principio a fin buscando ese email. Con un millón de usuarios, en el peor caso tendrías que hacer un millón de comparaciones. Con la estructura correcta (una tabla hash), esa misma búsqueda tarda lo mismo independientemente de si tienes 100 o 100 millones de usuarios.
# Búsqueda en lista: O(n) → el tiempo crece con el tamaño de los datos
emails_lista = ["ana@mail.com", "carlos@mail.com", ...]  # 1 millón de emails

# En el peor caso recorre TODA la lista
if "nuevo@mail.com" in emails_lista:
    print("Ya existe")

# Búsqueda en conjunto (tabla hash): O(1) → tiempo constante
emails_conjunto = {"ana@mail.com", "carlos@mail.com", ...}

# Instantáneo sin importar el tamaño
if "nuevo@mail.com" in emails_conjunto:
    print("Ya existe")
Este ejemplo ilustra por qué las estructuras de datos importan. Vamos a ver las principales.
Array (arreglo)
El array es la estructura de datos más básica y la que casi todos los lenguajes tienen de forma nativa. Almacena elementos en posiciones contiguas de memoria, identificadas por un índice que empieza en cero.
Característica clave: el acceso por índice es instantáneo porque el ordenador calcula directamente la posición en memoria (posición_base + índice × tamaño_elemento). No tiene que buscar el elemento.
# Python (listas)
numeros = [10, 20, 30, 40, 50]

# Acceso por índice: O(1) → instantáneo
print(numeros[0])    # 10
print(numeros[2])    # 30
print(numeros[-1])   # 50 (último elemento)

# Modificar por índice: O(1)
numeros[1] = 99
print(numeros)   # [10, 99, 30, 40, 50]

# Añadir al final: O(1) amortizado
numeros.append(60)

# Insertar en el medio: O(n) → hay que desplazar todos los elementos siguientes
numeros.insert(2, 25)   # inserta 25 en la posición 2

# Buscar un elemento: O(n) → hay que recorrer hasta encontrarlo
print(25 in numeros)    # True
print(numeros.index(25))  # devuelve el índice del elemento

# Eliminar del final: O(1)
numeros.pop()

# Eliminar del medio: O(n) → hay que desplazar elementos
numeros.pop(1)   # elimina el elemento en el índice 1
// JavaScript (arrays)
const numeros = [10, 20, 30, 40, 50];

console.log(numeros[0]);          // 10
console.log(numeros.length);      // 5
numeros.push(60);                 // añadir al final: O(1)
numeros.unshift(5);               // añadir al inicio: O(n) ← costoso
numeros.pop();                    // eliminar del final: O(1)
numeros.shift();                  // eliminar del inicio: O(n) ← costoso
console.log(numeros.indexOf(30)); // 1 (buscar: O(n))
Cuándo usar un array: cuando necesitas acceder a elementos por posición, cuando el orden importa, cuando iteras sobre todos los elementos frecuentemente. Es la estructura por defecto para la mayoría de colecciones ordenadas.
Cuándo NO es la mejor opción: cuando necesitas insertar o eliminar frecuentemente en el medio (muy lento), o cuando necesitas buscar elementos frecuentemente sin conocer su posición.
Lista enlazada (Linked List)
A diferencia del array, los elementos de una lista enlazada no están en posiciones contiguas de memoria. Cada elemento (nodo) guarda su valor y un puntero al siguiente nodo. El último nodo apunta a None/null.
# Visualización de una lista enlazada:
# [10 | →] → [20 | →] → [30 | →] → [40 | None]
# nodo1       nodo2       nodo3       nodo4
# Python: implementación de lista enlazada simple
class Nodo:
    def __init__(self, valor):
        self.valor    = valor
        self.siguiente = None   # puntero al siguiente nodo

class ListaEnlazada:
    def __init__(self):
        self.cabeza = None   # primer nodo

    def insertar_al_inicio(self, valor):
        nuevo = Nodo(valor)
        nuevo.siguiente = self.cabeza   # el nuevo apunta al antiguo primero
        self.cabeza = nuevo             # el nuevo es ahora el primero
        # O(1): no importa cuántos elementos haya

    def insertar_al_final(self, valor):
        nuevo = Nodo(valor)
        if not self.cabeza:
            self.cabeza = nuevo
            return
        actual = self.cabeza
        while actual.siguiente:    # recorrer hasta el último
            actual = actual.siguiente
        actual.siguiente = nuevo   # O(n): hay que llegar hasta el final

    def eliminar(self, valor):
        if not self.cabeza:
            return

        if self.cabeza.valor == valor:
            self.cabeza = self.cabeza.siguiente   # O(1) si es el primero
            return

        actual = self.cabeza
        while actual.siguiente:
            if actual.siguiente.valor == valor:
                actual.siguiente = actual.siguiente.siguiente  # saltar el nodo
                return
            actual = actual.siguiente
        # O(n): hay que buscar el elemento

    def imprimir(self):
        actual = self.cabeza
        elementos = []
        while actual:
            elementos.append(str(actual.valor))
            actual = actual.siguiente
        print(" → ".join(elementos))

# Usar la lista enlazada
lista = ListaEnlazada()
lista.insertar_al_inicio(30)
lista.insertar_al_inicio(20)
lista.insertar_al_inicio(10)
lista.imprimir()   # 10 → 20 → 30
lista.eliminar(20)
lista.imprimir()   # 10 → 30
Ventaja sobre el array: insertar o eliminar al inicio es O(1), porque no hay que desplazar elementos. Solo se cambia el puntero.
Desventaja sobre el array: el acceso por índice es O(n) porque no hay forma de saltar directamente a una posición: hay que recorrer desde el principio. Además, consume más memoria porque cada nodo guarda el valor y el puntero.
Cuándo usar una lista enlazada: cuando haces muchas inserciones y eliminaciones al inicio o en posiciones conocidas, y raramente accedes por índice. En la práctica, las listas enlazadas son más comunes como base de otras estructuras (pilas, colas) que como estructura directa.
Pila (Stack)
La pila sigue el principio LIFO: Last In, First Out (el último en entrar es el primero en salir). Piensa en una pila de platos: solo puedes coger el que está arriba, y solo puedes añadir uno encima del que ya está arriba.
Las operaciones fundamentales son push (añadir encima) y pop (quitar el de arriba). Ambas son O(1).
# Python: una lista funciona perfectamente como pila
pila = []

pila.append(1)   # push
pila.append(2)
pila.append(3)
print(pila)       # [1, 2, 3]
print(pila[-1])   # 3 ← ver el elemento superior sin sacarlo (peek)

elemento = pila.pop()   # pop: saca el último
print(elemento)         # 3
print(pila)             # [1, 2]
# Caso de uso clásico 1: verificar que los paréntesis están balanceados
def parentesis_balanceados(expresion):
    pila = []
    pares = {')': '(', ']': '[', '}': '{'}

    for caracter in expresion:
        if caracter in '([{':
            pila.append(caracter)    # apertura: añadir a la pila
        elif caracter in ')]}':
            if not pila or pila[-1] != pares[caracter]:
                return False         # cierre sin apertura correspondiente
            pila.pop()               # cierre correcto: sacar la apertura

    return len(pila) == 0   # True si todos los abiertos fueron cerrados

print(parentesis_balanceados("(a + b) * [c - d]"))   # True
print(parentesis_balanceados("(a + b] * c"))          # False
print(parentesis_balanceados("((a + b)"))             # False (falta cerrar)
# Caso de uso clásico 2: historial de navegación (botón "atrás")
class HistorialNavegacion:
    def __init__(self):
        self._historial = []
        self._adelante  = []

    def visitar(self, url):
        self._historial.append(url)
        self._adelante.clear()   # al visitar una nueva página, el historial adelante se borra
        print(f"Visitando: {url}")

    def atras(self):
        if len(self._historial) <= 1:
            print("No hay páginas anteriores")
            return
        actual = self._historial.pop()
        self._adelante.append(actual)
        print(f"Volviendo a: {self._historial[-1]}")

    def adelante(self):
        if not self._adelante:
            print("No hay páginas siguientes")
            return
        siguiente = self._adelante.pop()
        self._historial.append(siguiente)
        print(f"Avanzando a: {siguiente}")

nav = HistorialNavegacion()
nav.visitar("google.com")
nav.visitar("wikipedia.org")
nav.visitar("python.org")
nav.atras()     # Volviendo a: wikipedia.org
nav.atras()     # Volviendo a: google.com
nav.adelante()  # Avanzando a: wikipedia.org
Cuándo usar una pila: cuando necesitas procesar elementos en orden inverso al que llegaron, para implementar la función "deshacer" en editores, para evaluar expresiones matemáticas, para la gestión de llamadas a funciones (el call stack es una pila), y para algoritmos de recorrido en profundidad (DFS).
Cola (Queue)
La cola sigue el principio FIFO: First In, First Out (el primero en entrar es el primero en salir). Como la cola de un supermercado: el primero que llega es el primero que se atiende.
Las operaciones son enqueue (añadir al final) y dequeue (quitar del inicio). Ambas deben ser O(1).
# Python: usar deque (double-ended queue) de collections, más eficiente que una lista
from collections import deque

cola = deque()
cola.append(1)     # enqueue: añadir al final
cola.append(2)
cola.append(3)
print(cola)        # deque([1, 2, 3])

elemento = cola.popleft()   # dequeue: quitar del inicio → O(1)
print(elemento)             # 1
print(cola)                 # deque([2, 3])

# ¿Por qué no usar lista.pop(0)?
# lista.pop(0) es O(n): hay que desplazar todos los elementos
# deque.popleft() es O(1): operación constante
# Caso de uso: sistema de impresión (cola de trabajos)
from collections import deque

class ColaDeTrabajosImpresion:
    def __init__(self):
        self._cola = deque()

    def agregar_trabajo(self, documento):
        self._cola.append(documento)
        print(f"Trabajo '{documento}' añadido a la cola (posición {len(self._cola)})")

    def procesar_siguiente(self):
        if not self._cola:
            print("No hay trabajos en cola")
            return
        trabajo = self._cola.popleft()
        print(f"Imprimiendo: '{trabajo}'")
        return trabajo

    def trabajos_pendientes(self):
        return len(self._cola)

impresora = ColaDeTrabajoImpresion()
impresora.agregar_trabajo("informe_anual.pdf")
impresora.agregar_trabajo("factura_mayo.pdf")
impresora.agregar_trabajo("presentacion.pptx")
impresora.procesar_siguiente()   # Imprimiendo: 'informe_anual.pdf'
impresora.procesar_siguiente()   # Imprimiendo: 'factura_mayo.pdf'
print(f"Pendientes: {impresora.trabajos_pendientes()}")   # 1
Cuándo usar una cola: cuando necesitas procesar elementos en el mismo orden en que llegaron. Colas de tareas en servidores web, sistemas de mensajería, algoritmos de recorrido en anchura (BFS), gestión de eventos en interfaces gráficas.
Tabla hash (Diccionario / Objeto)
La tabla hash es probablemente la estructura de datos más útil y más usada en el desarrollo cotidiano. Almacena pares clave-valor y permite buscar, insertar y eliminar por clave en tiempo O(1) de media.
Cómo funciona por dentro: cuando insertas un par clave-valor, la tabla aplica una función hash a la clave para calcular en qué "casilla" del array interno guardar el valor. Cuando buscas por clave, aplica la misma función hash y va directamente a esa casilla, sin recorrer nada.
# Python: los diccionarios son tablas hash
agenda = {}

# Insertar: O(1)
agenda["ana@mail.com"]    = {"nombre": "Ana García",   "telefono": "600111222"}
agenda["carlos@mail.com"] = {"nombre": "Carlos López", "telefono": "600333444"}

# Buscar por clave: O(1) ← aquí está la magia
contacto = agenda.get("ana@mail.com")
print(contacto["nombre"])   # "Ana García"

# Comprobar existencia: O(1)
if "nuevo@mail.com" in agenda:
    print("Ya existe")

# Eliminar: O(1)
del agenda["carlos@mail.com"]

# Recorrer: O(n)
for email, datos in agenda.items():
    print(f"{email}: {datos['nombre']}")
# Caso de uso clásico: contar frecuencias en O(n)
def contar_palabras(texto):
    frecuencia = {}
    palabras = texto.lower().split()

    for palabra in palabras:
        frecuencia[palabra] = frecuencia.get(palabra, 0) + 1

    return frecuencia

texto = "el gato y el perro y el gato"
print(contar_palabras(texto))
# {"el": 3, "gato": 2, "y": 2, "perro": 1}

# Con Counter (más conciso):
from collections import Counter
print(Counter(texto.lower().split()))
# Caso de uso: caché (memoización) con tabla hash
def fibonacci_con_cache(n, cache={}):
    if n <= 1:
        return n
    if n in cache:
        return cache[n]   # O(1): ya calculado
    resultado = fibonacci_con_cache(n-1, cache) + fibonacci_con_cache(n-2, cache)
    cache[n] = resultado   # guardar para no recalcular
    return resultado

print(fibonacci_con_cache(50))  # instantáneo gracias al caché
# Sin caché, fibonacci(50) tardaría días en ejecutarse
Cuándo usar una tabla hash: cuando necesitas búsquedas frecuentes por clave, para eliminar duplicados, para contar frecuencias, para implementar cachés y para cualquier caso donde la relación es clave → valor.
Conjunto (Set)
Un conjunto es como una tabla hash pero que solo guarda claves, sin valores asociados. Garantiza que no hay elementos duplicados y permite operaciones matemáticas de conjuntos (unión, intersección, diferencia) de forma eficiente.
# Python: sets
emails_registrados = {"ana@mail.com", "carlos@mail.com", "maria@mail.com"}

# Buscar: O(1)
if "ana@mail.com" in emails_registrados:
    print("Email ya registrado")

# Añadir: O(1)
emails_registrados.add("jorge@mail.com")

# Los duplicados se ignoran automáticamente
emails_registrados.add("ana@mail.com")   # ya existe, no hace nada
print(len(emails_registrados))           # sigue siendo 4

# Eliminar duplicados de una lista: truco clásico
con_duplicados = [1, 2, 2, 3, 3, 3, 4]
sin_duplicados = list(set(con_duplicados))   # [1, 2, 3, 4]

# Operaciones de conjuntos
a = {1, 2, 3, 4, 5}
b = {3, 4, 5, 6, 7}

print(a & b)    # {3, 4, 5}        intersección: elementos en ambos
print(a | b)    # {1,2,3,4,5,6,7}  unión: todos los elementos
print(a - b)    # {1, 2}           diferencia: en a pero no en b
print(a ^ b)    # {1, 2, 6, 7}     diferencia simétrica: en uno pero no en ambos
# Caso de uso: encontrar elementos comunes entre dos listas
def amigos_en_comun(amigos_ana, amigos_carlos):
    return set(amigos_ana) & set(amigos_carlos)

amigos_de_ana    = ["María", "Jorge", "Lucía", "Pedro", "Sara"]
amigos_de_carlos = ["Jorge", "Sara", "Tomás", "Lucía"]

comunes = amigos_en_comun(amigos_de_ana, amigos_de_carlos)
print(comunes)   # {"Jorge", "Sara", "Lucía"}
Árbol (Tree)
Un árbol es una estructura jerárquica donde cada elemento (nodo) puede tener un nodo padre y varios nodos hijos. El nodo sin padre es la raíz. Los nodos sin hijos son las hojas.
El árbol más importante para un programador principiante es el árbol binario de búsqueda (BST): cada nodo tiene como máximo dos hijos, y todos los valores del subárbol izquierdo son menores que el nodo actual, mientras que todos los del subárbol derecho son mayores.
#       8          ← raíz
#      / \
#     3   10       ← nodos internos
#    / \    \
#   1   6    14    ← hojas
#      / \
#     4   7

# Propiedad del BST: para cualquier nodo n
# todos los nodos del subárbol izquierdo tienen valor < n
# todos los nodos del subárbol derecho tienen valor > n

# Esto permite buscar en O(log n): en cada paso, se descarta la mitad del árbol
# Python: árbol binario de búsqueda
class NodoArbol:
    def __init__(self, valor):
        self.valor    = valor
        self.izquierda = None
        self.derecha   = None

class ArbolBinarioBusqueda:
    def __init__(self):
        self.raiz = None

    def insertar(self, valor):
        self.raiz = self._insertar(self.raiz, valor)

    def _insertar(self, nodo, valor):
        if nodo is None:
            return NodoArbol(valor)
        if valor < nodo.valor:
            nodo.izquierda = self._insertar(nodo.izquierda, valor)
        elif valor > nodo.valor:
            nodo.derecha = self._insertar(nodo.derecha, valor)
        return nodo   # si es igual, no se inserta (no hay duplicados)

    def buscar(self, valor):
        return self._buscar(self.raiz, valor)

    def _buscar(self, nodo, valor):
        if nodo is None:
            return False   # llegamos a una hoja sin encontrarlo
        if valor == nodo.valor:
            return True
        if valor < nodo.valor:
            return self._buscar(nodo.izquierda, valor)   # buscar en la izquierda
        return self._buscar(nodo.derecha, valor)          # buscar en la derecha

    def recorrido_ordenado(self):
        """Recorre el árbol en orden: izquierda → raíz → derecha. Devuelve los valores ordenados."""
        resultado = []
        self._inorden(self.raiz, resultado)
        return resultado

    def _inorden(self, nodo, resultado):
        if nodo:
            self._inorden(nodo.izquierda, resultado)
            resultado.append(nodo.valor)
            self._inorden(nodo.derecha, resultado)

arbol = ArbolBinarioBusqueda()
for valor in [8, 3, 10, 1, 6, 14, 4, 7]:
    arbol.insertar(valor)

print(arbol.buscar(6))   # True
print(arbol.buscar(5))   # False
print(arbol.recorrido_ordenado())   # [1, 3, 4, 6, 7, 8, 10, 14] ← ordenados!
Cuándo aparecen los árboles en la práctica: el sistema de archivos de tu ordenador es un árbol, el DOM de HTML es un árbol, los menús con submenús son árboles, los sistemas de bases de datos usan árboles B internamente para los índices.
Grafo (Graph)
Un grafo es la estructura de datos más general: un conjunto de nodos (vértices) conectados por aristas (edges). A diferencia del árbol, en un grafo puede haber ciclos (puedes volver al punto de partida siguiendo conexiones) y un nodo puede tener cualquier número de conexiones en cualquier dirección.
# Formas de representar un grafo:

# 1. Lista de adyacencia (la más común): diccionario donde cada clave es un nodo
#    y su valor es la lista de nodos con los que está conectado
grafo = {
    "A": ["B", "C"],
    "B": ["A", "D", "E"],
    "C": ["A", "F"],
    "D": ["B"],
    "E": ["B", "F"],
    "F": ["C", "E"]
}

# Visualización:
# A — B — D
# |   |
# C   E
# |   |
# F———┘

# 2. Matriz de adyacencia: una cuadrícula de 0s y 1s
# matriz[i][j] = 1 significa que hay una arista entre el nodo i y el nodo j
# Recorrido en anchura (BFS): explora nivel por nivel
# Útil para encontrar el camino más corto entre dos nodos
from collections import deque

def bfs(grafo, inicio, destino):
    visitados = {inicio}
    cola = deque([[inicio]])   # cola de caminos, no solo de nodos

    while cola:
        camino = cola.popleft()
        nodo_actual = camino[-1]

        if nodo_actual == destino:
            return camino   # encontramos el camino más corto

        for vecino in grafo[nodo_actual]:
            if vecino not in visitados:
                visitados.add(vecino)
                cola.append(camino + [vecino])

    return None   # no hay camino

print(bfs(grafo, "A", "F"))   # ["A", "C", "F"] ← camino más corto
Cuándo aparecen los grafos en la práctica: las redes sociales son grafos (usuarios conectados por amistades), los mapas de navegación son grafos (ciudades conectadas por carreteras), internet es un grafo (servidores conectados por cables), los sistemas de recomendación usan grafos para encontrar similitudes.
Tabla comparativa de operaciones
| Estructura | Acceso | Búsqueda | Inserción | Eliminación | Mejor para |
|---|---|---|---|---|---|
| Array | O(1) | O(n) | O(n)* | O(n)* | Acceso por índice, iteración |
| Lista enlazada | O(n) | O(n) | O(1)** | O(1)** | Inserciones/eliminaciones frecuentes al inicio |
| Pila | O(n) | O(n) | O(1) | O(1) | Procesamiento LIFO, deshacer acciones |
| Cola | O(n) | O(n) | O(1) | O(1) | Procesamiento FIFO, colas de tareas |
| Tabla hash | O(1) | O(1) | O(1) | O(1) | Búsqueda por clave, conteo, caché |
| Conjunto | — | O(1) | O(1) | O(1) | Verificar pertenencia, eliminar duplicados |
| BST | O(log n) | O(log n) | O(log n) | O(log n) | Datos ordenados con búsqueda eficiente |
* O(1) al insertar o eliminar al final del array. O(n) en el medio o al inicio.
** O(1) si ya tienes la referencia al nodo anterior. O(n) si hay que buscar primero.
Cómo elegir la estructura correcta
Estas preguntas te ayudan a elegir rápido:
- ¿Necesitas acceder a elementos por posición? → Array/lista
- ¿Necesitas buscar por clave frecuentemente? → Tabla hash (diccionario)
- ¿Necesitas verificar si algo existe sin importar el orden? → Conjunto (set)
- ¿Necesitas procesar en orden inverso al que llegó? → Pila
- ¿Necesitas procesar en el mismo orden en que llegó? → Cola
- ¿Los datos tienen jerarquía (padre-hijo)? → Árbol
- ¿Los datos tienen conexiones arbitrarias entre sí? → Grafo
- ¿Haces muchas inserciones al inicio? → Lista enlazada
Resumen
- Los arrays son la estructura base: acceso instantáneo por índice, pero insertar o eliminar en el medio es lento.
- Las listas enlazadas permiten insertar y eliminar al inicio en O(1), pero el acceso por índice es lento.
- Las pilas (LIFO) son perfectas para procesar en orden inverso, implementar "deshacer" o gestionar llamadas anidadas.
- Las colas (FIFO) son perfectas para procesar tareas en el orden en que llegaron.
- Las tablas hash (diccionarios) ofrecen búsqueda, inserción y eliminación en O(1). Son la estructura más usada en el desarrollo cotidiano.
- Los conjuntos garantizan unicidad y permiten operaciones de conjuntos matemáticos eficientemente.
- Los árboles binarios de búsqueda mantienen los datos ordenados con operaciones en O(log n).
- Los grafos representan conexiones arbitrarias entre elementos: redes sociales, mapas, internet.
No hay comentarios todavía. Sé el primero en compartir tu opinión.